
Blockchain-Datenindexierung
Fragt man einen Blockchain-Node nach jedem Transfer, den eine Wallet je gemacht hat, kann er es nicht sagen, jedenfalls nicht in einer Zeit, die jemand abwartet. Blockchains sind für Prüfung und Unveränderlichkeit gebaut und nicht für Suche; jedes Onchain-Produkt, das eine Bank oder ein Fonds anfasst, sitzt also auf einem Index aus der rohen Kette.
Es folgt, warum ein Block die falsche Form für eine Abfrage ist, was ein Indexer aus Ereignissen und Traces macht, wie eine Kettenumorganisation behandelt wird, was Vertragsaktualisierungen mit der Dekodierung tun und wo der Abstand zwischen einer indexierten und einer geprüften Zahl liegt.
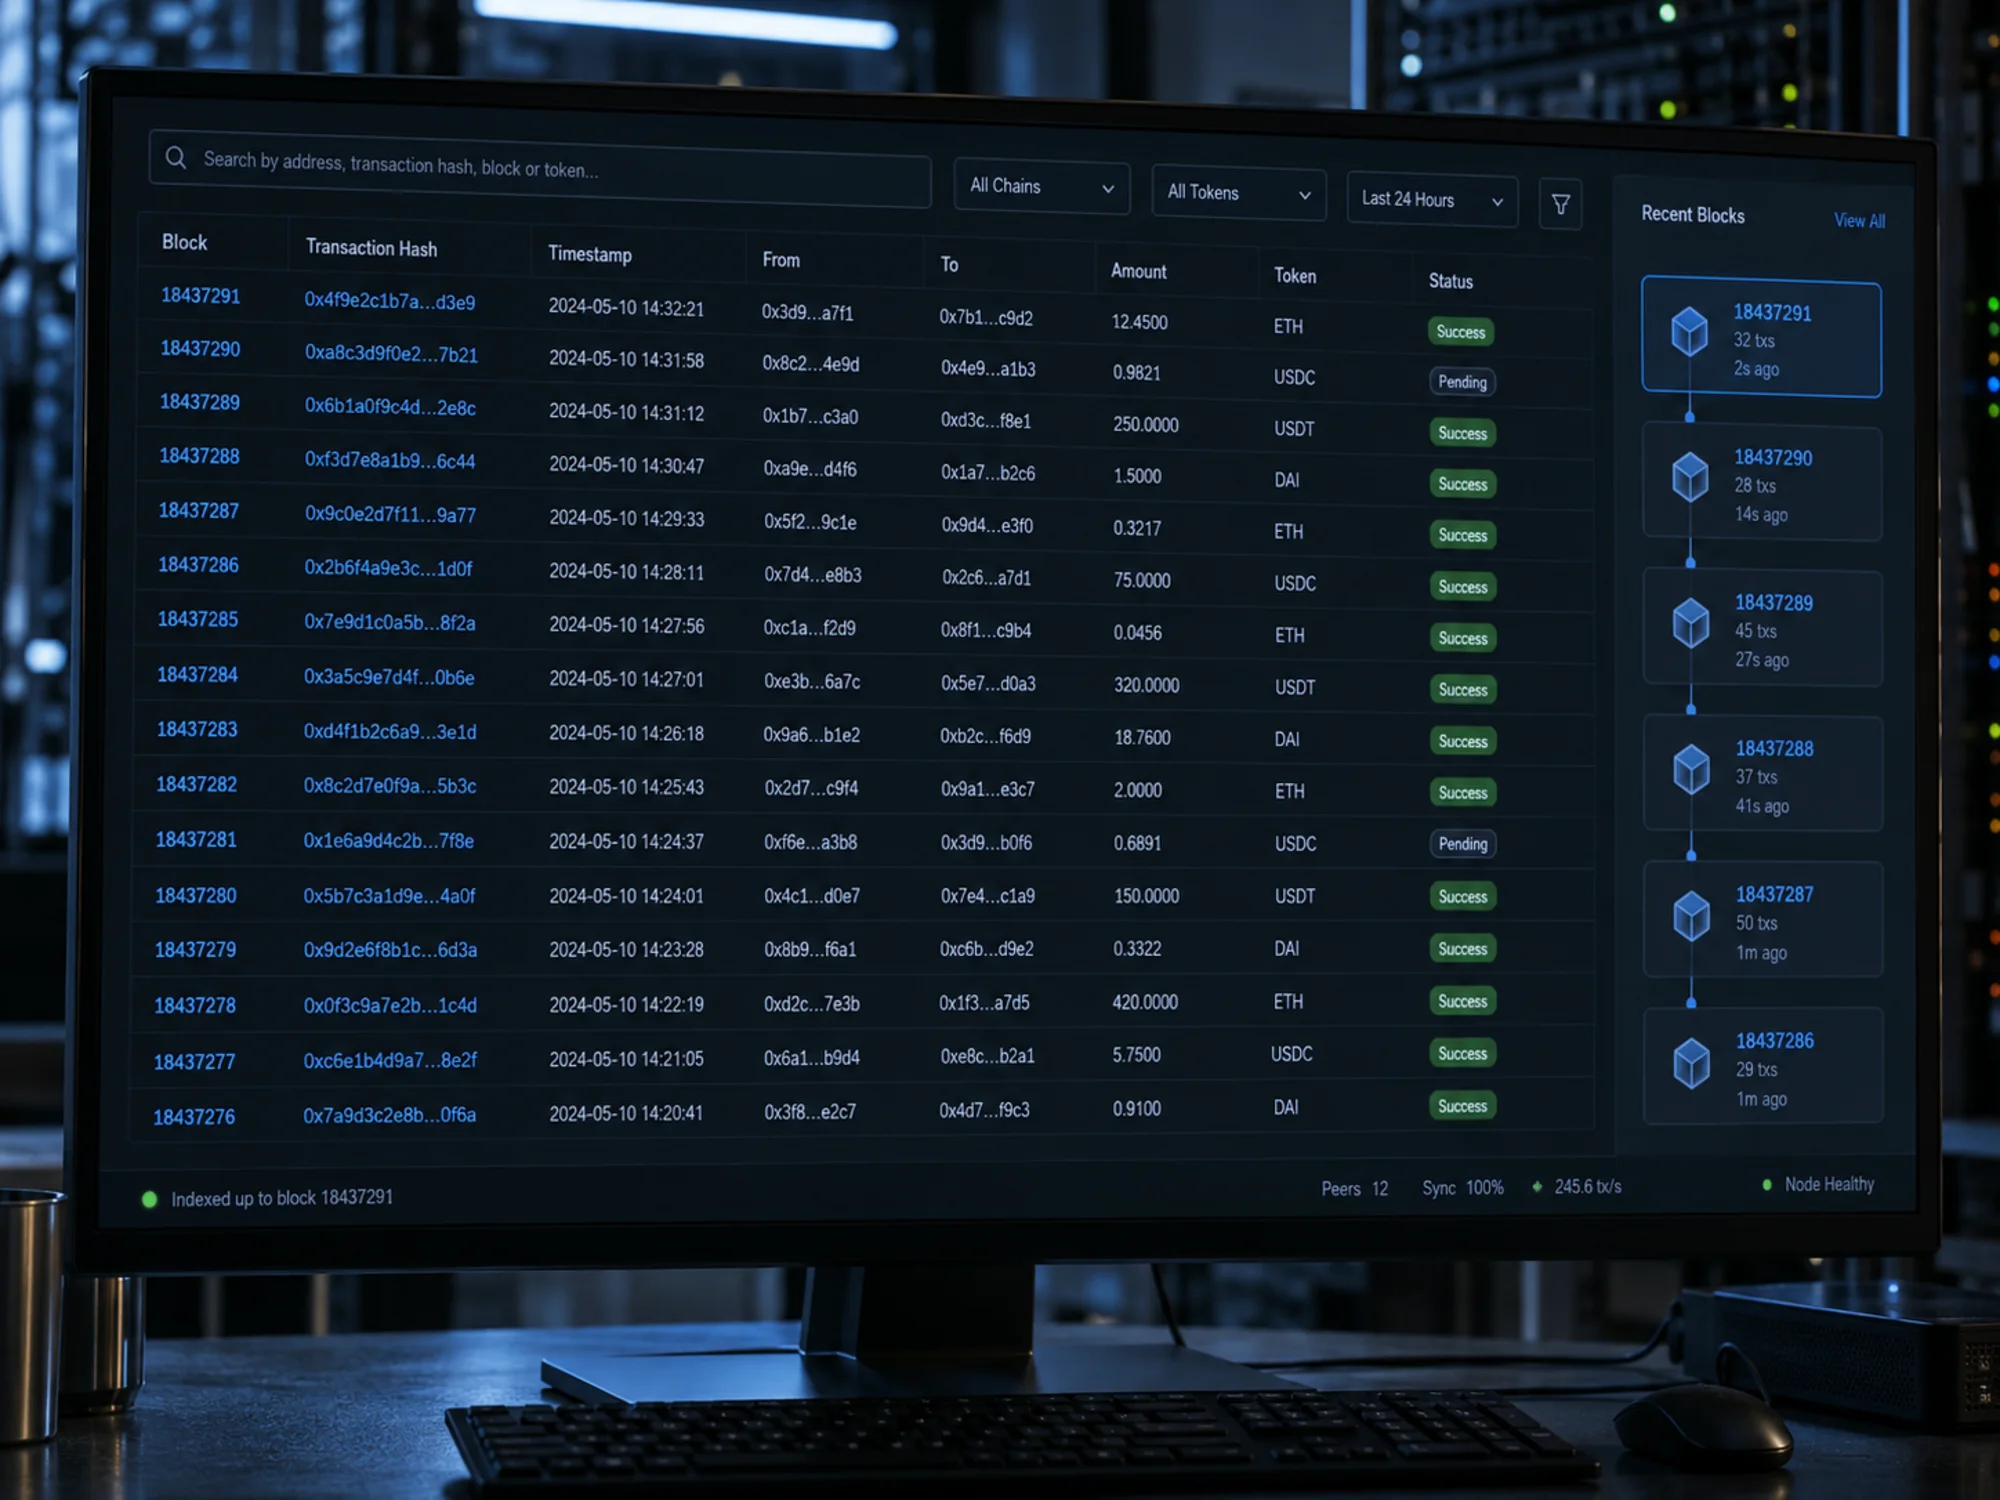
Warum ein Block die falsche Form für eine Frage ist
Eine Kette speichert Blöcke in Folge, jeder mit Transaktionen und den Logs, die sie ausgaben. Nichts in dieser Struktur beantwortet eine Frage wie "alle Transfers mit dieser Adresse" oder "der Saldo dieses Tokens über diese hundert Konten", denn die Daten sind nach Zeit geordnet und nicht nach Gegenstand. So eine Frage allein aus der Kette zu beantworten heißt, Millionen Blöcke der Reihe nach zu durchsuchen; darum bieten die üblichen RPC-Methoden es nicht an.
Ein Indexer löst das, indem er die Ordnung umkehrt. Er liest Blöcke einmal, holt die Ereignisse und die Ausführungs-Traces heraus, dekodiert sie zu Datensätzen mit benannten Feldern und schreibt sie in eine Datenbank mit Indizes auf den abgefragten Feldern. Das ist eine Extraktions-, Transformations- und Ladestrecke der Art, die eine Bank für andere Daten schon betreibt. Die Abfrage dauert dann Millisekunden, weil die Arbeit vorher geschah.
Ereignisse gegen Traces, und warum es beide braucht
Ein Ereignis-Log ist das, was ein Vertrag absichtlich ausgab; das macht es billig zu lesen und abhängig davon, dass der Vertragsautor es ausgab. Die meisten Token-Transfers erscheinen als Ereignisse, darum ist eine Transferhistorie das Einfachste zu indexieren.
Ausführungs-Traces sind die Aufzeichnung dessen, was in einer Transaktion wirklich geschah, samt interner Aufrufe zwischen Verträgen, die nichts ausgaben. Gebraucht werden sie genau dort, wo Ereignisse fehlen oder irreführen: ein Transfer der Netzwährung innerhalb eines Vertragsaufrufs, ein fehlgeschlagener Unteraufruf in einer sonst erfolgreichen Transaktion oder ein Vertrag, der eine Handlung einfach nicht protokolliert. Praktisch heißt das für ein Haus, den Anbieter zu fragen, aus welchem von beiden sein Index gebaut ist, denn ein Index nur aus Ereignissen hat blinde Flecken, die erst auffallen, wenn ein Saldo nicht abgleicht.
Subgraphs und die Indexierungsdienste dahinter
The Graph ist das am weitesten verbreitete dezentrale Indexierungsprotokoll, und die Arbeitseinheit darin ist ein Subgraph: eine Spezifikation, welche Verträge zu beobachten sind, auf welche Ereignisse zu hören ist und wie diese Ereignisdaten in ein über GraphQL abfragbares Schema abzubilden sind. Unabhängige Betreiber, Indexer genannt, führen die Verarbeitung und liefern die Abfragen.
Daneben stehen zwei andere Formen. Ein verwalteter Indexierungsanbieter betreibt die Strecke und übergibt eine API; das nimmt den Betrieb und fügt einen Lieferanten hinzu. Ein Push- oder Streaming-Dienst dreht die Richtung und liefert gefilterte Kettendaten laufend in das Ziel des Hauses; das passt, wer die Daten im eigenen Lager neben allem anderen Gemeldeten will. Jede der drei ist eine andere Abhängigkeit, und die DORA-Frage der Seite RPC-Anbieter gilt für alle.
Reorgs: wenn die Kette es sich anders überlegt
Eine Kettenumorganisation tritt ein, wenn die maßgebliche Kette wechselt, weil konkurrierende Blöcke auf gleicher Höhe entstanden und das Netz sich auf eine andere Abzweigung einigt als die, die der Indexer schon verarbeitet hat. Alles, was der Indexer aus den verwaisten Blöcken schrieb, ist nun falsch: Transaktionen, die er als geschehen führte, geschahen auf der Kette nicht, der alle anderen nun folgen.
Ein richtiger Indexer erkennt den Reorg also, rollt die betroffenen Datensätze zurück und verarbeitet ab dem Abzweigpunkt neu; wer das nicht tut, meldet Phantomtransaktionen, die nie abschließen. Für ein Finanzhaus ist das keine technische Fußnote. Ein Indexer, der nur Blöcke jenseits der Finalitätsschwelle verarbeitet, hat das Problem nie, einer am Kettenkopf immer. Eine vor Finalität gelesene Zahl kann revidiert werden, eine Melde- oder Bewertungsstrecke muss also angeben, welche Bestätigungstiefe sie als endgültig behandelt, und bei einem Reorg über diese Linie neu stellen können. Ein Index, dessen Anbieter seine Reorg-Behandlung nicht beschreiben kann, sollte keine gemeldete Zahl tragen.
Verträge dekodieren: ABIs, Proxys, Updates
Kettendaten kommen hexadezimal. Daraus ein benanntes Feld zu machen braucht die ABI des Vertrags, die Schnittstellenbeschreibung, die sagt, welches Ereignis welche Parameter in welcher Ordnung hat; ohne die richtige ABI ist ein Ereignis ein undekodierbarer Klumpen. Damit hängt ein Index an einer Information, die außerhalb der Kette liegt.
Proxy-Verträge erschweren das auf eine Weise, die Meldestrecken überrascht. Ein Proxy hält den Speicher und leitet Aufrufe an einen austauschbaren Implementierungsvertrag weiter, die Adresse bleibt also gleich, während Logik und Ereignissignaturen darunter wechseln. Ein Index, der gegen die alte Implementierung dekodierte, erzeugt nach einer Aktualisierung weiter plausible Datensätze aus dem falschen Schema, und nichts in den Daten kündigt den Wechsel an. Zu fragen ist der Anbieter, wie er einen Implementierungswechsel erkennt, und dieselbe Frage gilt für die eigene Strecke.
Eine indexierte Zahl ist keine geprüfte
Hier hört das Thema auf technisch zu sein. Eine Zahl aus einem Index ist das Ergebnis einer Strecke mit Entscheidungen darin: welche Ketten einbezogen wurden, welche Bestätigungstiefe als endgültig galt, welche Adressen welcher Einheit zugeordnet wurden, mit welcher ABI-Version dekodiert wurde und was mit den Datensätzen aus einem Reorg geschah. Zwei Anbieter können zwei verschiedene Summen für dasselbe Portfolio liefern, ohne dass einer sich über die Kette irrt.
Für den Nettoinventarwert eines Fonds oder einen gemeldeten Bestand einer Bank braucht die Zahl eine dokumentierte Herleitung und einen Abgleich gegen eine zweite Quelle, bei verwahrten Werten die Aufzeichnungen des Verwahrers. Nützlich ist die Disziplin, die für Marktdaten schon gilt: Quelle nennen, Zeit nennen, Methode nennen und die Eingaben behalten, damit die Zahl später reproduzierbar ist. Die Seite Onchain-Analyse im Finanzwesen behandelt die Zuordnungsschicht darüber, wo der Fehler größer ist.
Index bauen oder kaufen?
Kaufen für die Breite, bauen für die Zahlen, die das Haus verantwortet. Ein eigener Indexer gibt volle Kontrolle über Dekodierung, Reorg-Behandlung und Schema und kostet ein Team im Bau und Betrieb: Blockaufnahme, Dekodierung, Schemaentwurf, Reorg-Erholung, Überwachung und der Nachlauf bei jeder Schemaänderung. Ein Anbieter nimmt all das weg und macht die gemeldeten Zahlen des Hauses von einer Methode abhängig, die es nicht steuert.
Die Teilung, bei der die meisten Häuser landen, ist ein Anbieter für Erkundung und breite Abdeckung plus eine schmale eigene Strecke für die wenigen Verträge und Adressen, die eine Meldung füttern. Die schmale Strecke ist klein genug zum Prüfen und Abnehmen; darauf kommt es an.
Wie lange dauert es, eine Kette neu zu indexieren?
Tage bis Wochen für eine belebte Kette, und die Zahl bestimmt der Nachlauf und nicht das Mithalten. Jeden historischen Block zu lesen, zu dekodieren und in eine Datenbank zu schreiben ist durch den Lesedurchsatz des Archive Nodes und den Schreibdurchsatz der Strecke begrenzt, und eine Kette mit Jahren Historie und hohem Durchsatz heißt Terabytes zu verarbeiten. Die Betriebsfalle ist, dass jede Schemaänderung oder ABI-Korrektur den Nachlauf des betroffenen Bereichs erneut verlangt; ein Haus plant Neuindexierung also als normales Ereignis und nicht als Störfall.
Onchain-Daten und Finance Loop
Finance Loop bringt die Datentechniker dieser Strecken mit den Fondsbuchhaltern und Meldeteams zusammen, die die Zahlen daraus vertreten müssen, in den Tracks Investment & Digital Assets und Digital Infrastructure & Sovereignty. Finance Loop hält diese Termine in Frankfurt, nahe den Fonds und Banken, die Onchain-Bestände melden.
Finance Loop ist ein Experten-Netzwerk und will neue Technologien im Finanzwesen voranbringen, wie KI, Tokenisierung, Stablecoins und DeFi. Finance Loop hilft seinen Mitgliedern, Fähigkeiten und persönliche Netzwerke in diesen Feldern aufzubauen: Investment & digitale Vermögenswerte, Payments & digitales Geld, Digitale Infrastruktur & Souveränität und Risk & Compliance.