
KI-Infrastruktur in Banken: wo die Rechenleistung steht
Eine Bank mit eigenen Modellen hat drei Entscheidungen zu treffen, bevor ein Modell gewählt ist, und jede davon betrifft die Infrastruktur. Muss die Bank trainieren oder nur ausführen, was ein anderer trainiert hat. Steht die Rechenleistung im eigenen Rechenzentrum, in einer souveränen Cloud oder bei einem Hyperscaler. Und hält die Bank die Modellgewichte selbst oder ruft sie eine API. Die Antworten bestimmen Kosten, Aufsichtsakte und das, was ein Prüfer zwei Jahre später zu sehen bekommt.
Was Banken mit KI tun, steht unter KI im Banking in Deutschland, das europäische Bild unter KI in der Finanzbranche in Europa. Hier geht es um die Schicht darunter.
Inferenz oder Training, und was eine Bank braucht
Kaum eine Bank muss ein Basismodell trainieren, und wer das glaubt, braucht meist etwas anderes. Training von null heißt tausende Beschleuniger über Wochen, eine Datenpipeline, die im Haus noch keiner gebaut hat, und ein Ergebnis hinter den offenen Veröffentlichungen. Ein vorhandenes Modell auf eigenen Dokumenten nachzutrainieren ist eine andere Größenordnung: zehn Beschleuniger über Stunden, wiederholbar, und am Ende ein Modell unter eigener Kontrolle.
Die Last, die wirklich wiederkehrt, ist Inferenz. Sie läuft jedes Mal, wenn ein Kreditanalyst einen Dokumentenbestand befragt oder ein Servicefall zusammengefasst wird, und sie muss die Latenz des Fachbereichs treffen, nicht die des Anbieterprospekts. Beim Echtzeit-Betrugsscoring trennt sich das: Eine Entscheidung, die in eine Zahlungsautorisierung passen muss, wartet nicht auf eine externe API, und diese einzige Anforderung zieht die Last auf eigene Infrastruktur. Besser werden die meisten Antworten durch Abruf aus den eigenen Daten, nicht durch einen weiteren Trainingslauf, denn das Modell war nie der Teil, dem das Hauswissen fehlte.
Eigenes Rechenzentrum, Private Cloud, souveräne Cloud, Hyperscaler
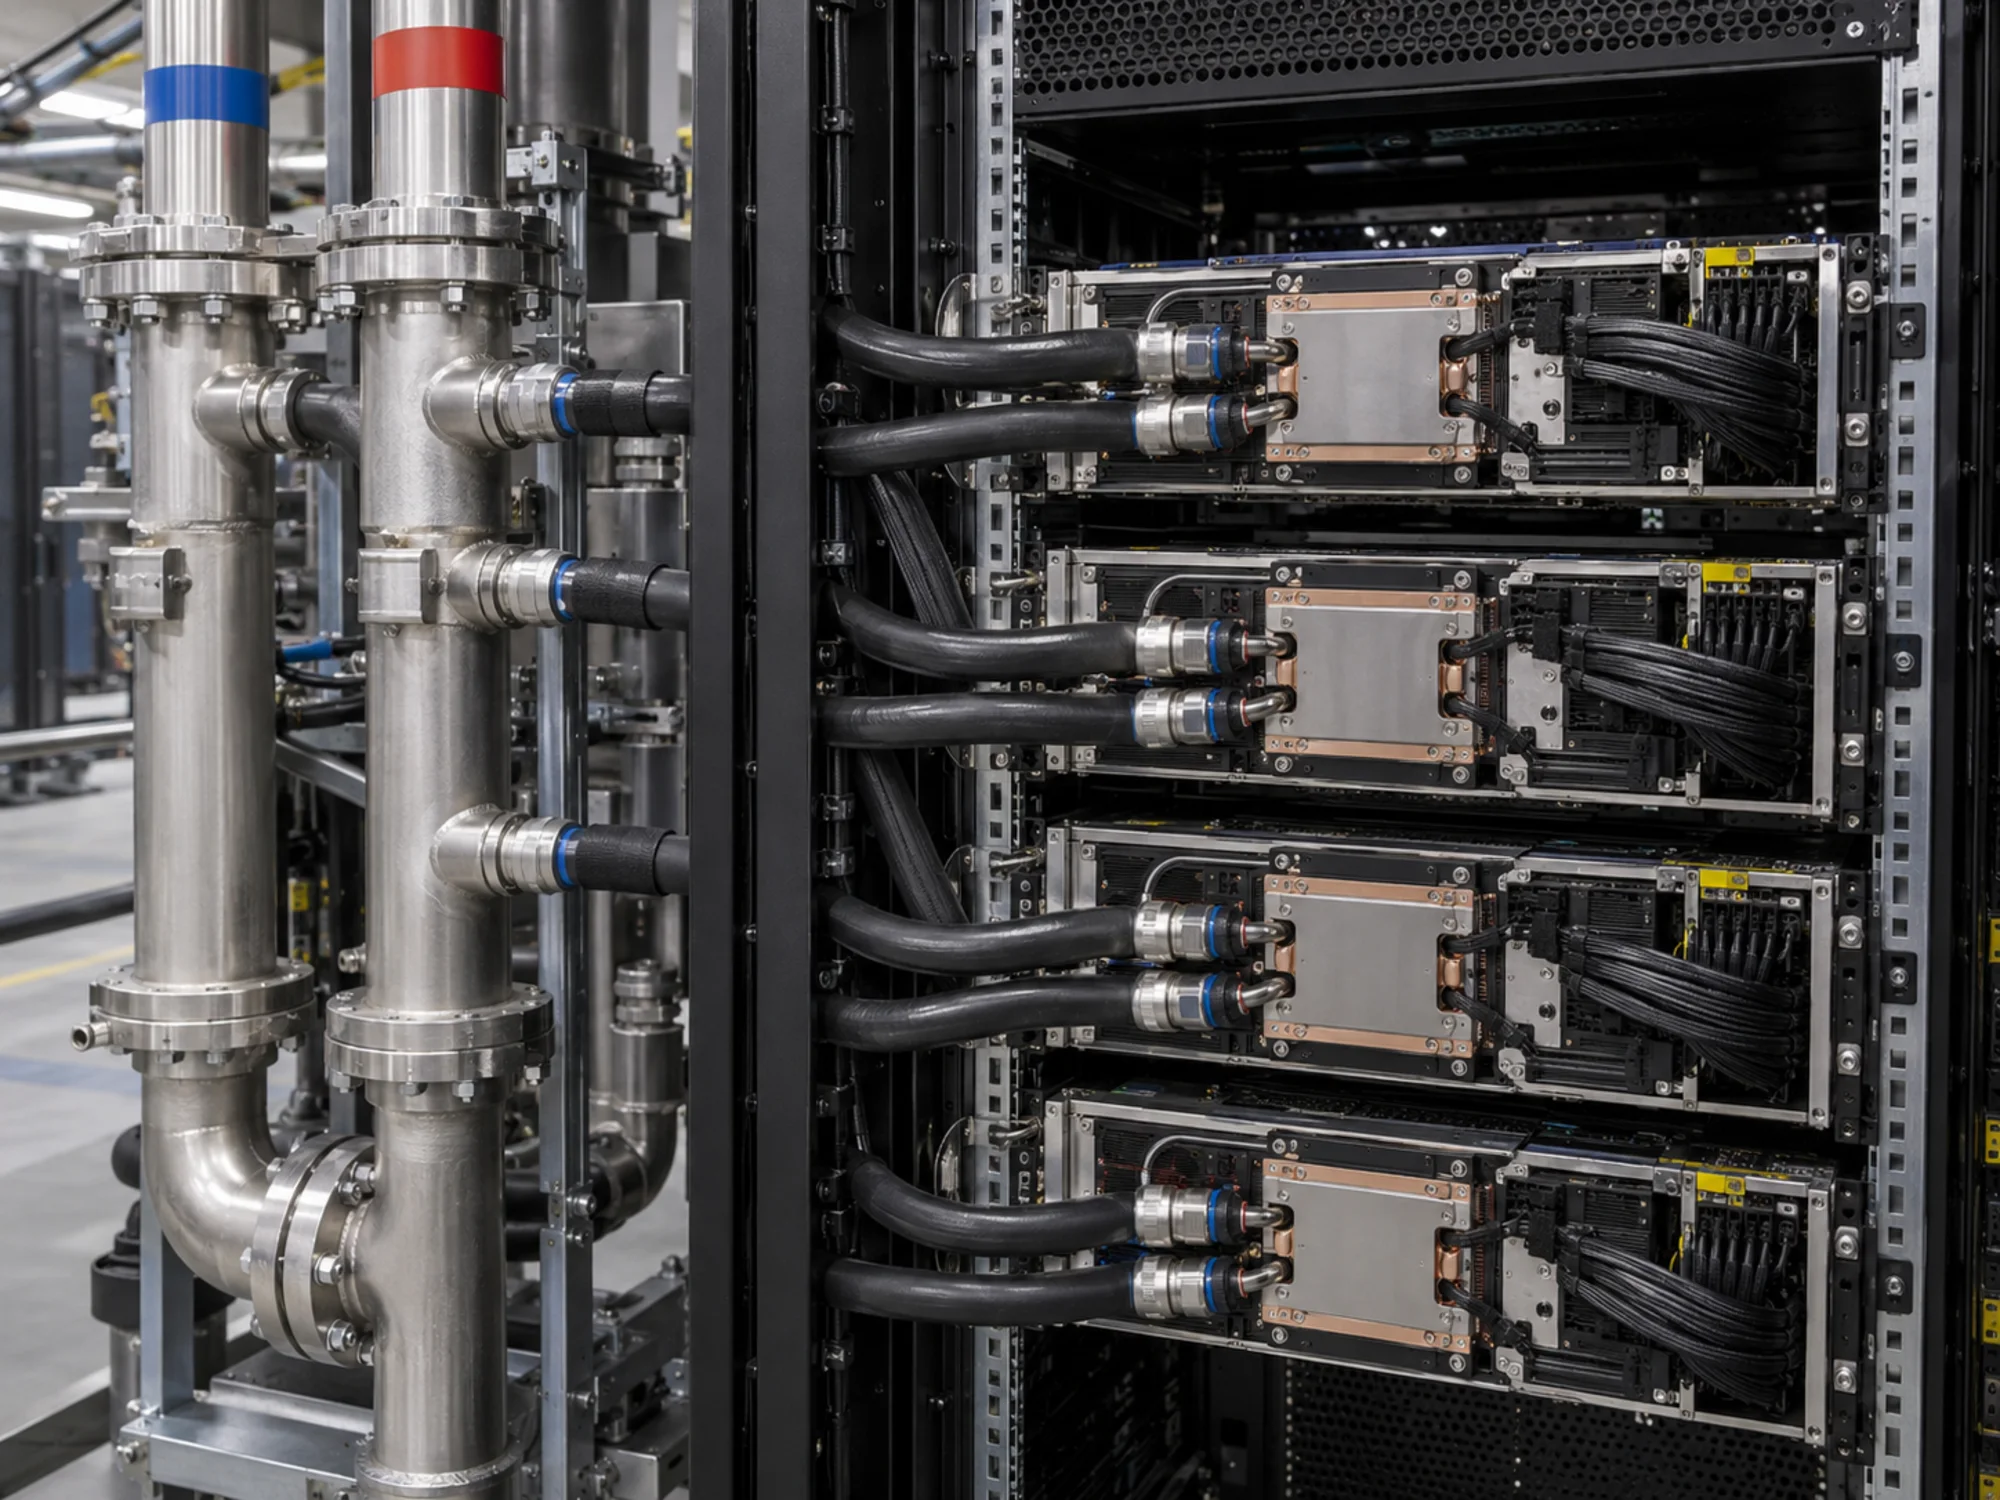
Vier Orte, vier Problemlagen. Das eigene Rechenzentrum liefert die stärkste Kontrollgeschichte: Modell, Inferenzschicht und Datenpipeline stehen in einem Gebäude, das die Bank besitzt oder mietet, und Kundendaten verlassen den Perimeter nie. Der Preis sind Beschaffung von Beschleunigern, Strom und Kühlung für Racks mit deutlich höherer Leistungsaufnahme als die ersetzten Server, und ein Hardwarezyklus, der nun der Bank gehört.
Eine souveräne Cloud legt die Last zu einem Betreiber, der an eine Rechtsordnung gebunden ist: vertragliche und teils gesetzliche Zusagen, dass Daten, Schlüssel und operative Kontrolle in einem benannten Rechtsraum bleiben, betrieben von einer diesem Recht unterworfenen Einheit. Die Seite dazu ist souveräne Cloud für Banken. Dazwischen liegt die Private Cloud: eigene Mandantenfähigkeit bei einem großen Anbieter, mit starker logischer Trennung und Bereitstellung in Wochen statt Quartalen. Sphere vergleicht die drei Modelle und stellt die Zeitachsen nebeneinander, sechs bis zwölf Monate und mehr für den Eigenbau gegen Wochen für eigene Mandanten, und nennt für die souveräne Variante einen Compliance-Zuschlag auf die einfache Private Cloud. Ein Hyperscaler liefert Kapazität und Modellauswahl sofort und lässt die Bank darüber streiten, welche Einheit die Schlüssel hält und welche Beschäftigten außerhalb der EU an die Steuerungsebene kommen.
Die europäische Antwort darauf wird gebaut. Lloyds Banking Group und NatWest Group gehören zu einer Koalition um ein britisches souveränes Spitzenmodell, damit Banken das Modell in eigener Infrastruktur betreiben können, statt Kundendaten an eine ausländische API zu senden. Dieselbe Frage treibt die Debatte um souveräne KI in Deutschland, wo sie auf Gaia-X und den EU Cloud Code of Conduct trifft.
Offene Gewichte, geschlossene API und die Prüfspur
Ein Open-Weight-Modell ist eine Datei, die die Bank halten kann. Das erlaubt drei Dinge, die eine geschlossene API nicht erlaubt: Die genaue Modellversion lässt sich so lange einfrieren, wie eine Aufsicht nach einer Entscheidung fragen könnte, das Modell läuft ohne Netzverbindung nach außen, und die Bank kann belegen, dass sich die Gewichte zwischen Entscheidung und Prüfung nicht geändert haben. Ein geschlossenes Modell hinter einer API aktualisiert der Anbieter, und eine Entscheidung gegen die Version des Vorquartals ist nach deren Abschaltung nicht reproduzierbar.
Geschlossene Modelle liefern Fähigkeiten, hinter denen offene Veröffentlichungen oft zurückbleiben, und einen Anbieter, der den Betrieb trägt. In regulierten Häusern setzt sich beides durch: ein geschlossenes Modell für Entwürfe und Recherche, wo keine Entscheidung daran hängt, und ein selbst betriebenes Open-Weight-Modell, wo eine hängt. Die Frage ist nicht, welches Modell im Benchmark vorn liegt, sondern welche Entscheidungen rekonstruierbar sein müssen, und wie lange. Die Modellschicht behandelt Finance Loop unter Large Language Models in der Finanzbranche und generative KI in der Finanzbranche.
Datenresidenz für Prompts und Ausgaben
Ein Prompt mit einem Kundennamen ist eine Übermittlung personenbezogener Daten, und zwar jedes Mal, nicht einmal zum Projektstart. Die DSGVO gilt für den Prompt, für Protokolle, die der Anbieter davon führt, für die Ausgabe und für den Abrufindex aus Kundendokumenten. Geklärt wird das mit konkreten Fragen: wo der Inferenzendpunkt physisch läuft, wie lange der Anbieter Prompts aufbewahrt und wozu, ob die Daten in sein Modell einfließen, und welche seiner Beschäftigten im Support einen Prompt lesen können.
Der Abrufindex ist der vergessene Teil. Eine Vektordatenbank aus Kundenkorrespondenz enthält dieselben personenbezogenen Daten wie die Korrespondenz, unterliegt denselben Löschpflichten und ist neu zu bauen, wenn ein Datensatz gelöscht wird. Ein Löschbegehren, das das Quelldokument entfernt und sein Embedding stehen lässt, ist keine Löschung.
DORA angewandt auf einen Modellanbieter
Ein Modellanbieter ist ein IKT-Drittdienstleister, und DORA behandelt ihn als solchen. Der Vertrag trägt also die Pflichtklauseln zu Zugang, Prüfung und Ausstieg, der Anbieter steht im Informationsregister des Hauses, und das Haus muss sagen können, was mit der Funktion passiert, wenn der Anbieter sie nicht mehr erbringt. Bei einem Modell ist das schwerer als bei einer Datenbank, denn ein Ausstiegsplan muss das Ersatzmodell benennen und sagen, wie Prompts, Abrufschicht und Evaluationsdaten dorthin wandern.
Die zweite Frage von DORA ist Konzentration. Eine Bank, deren Betrugsscoring, Kundenservice und Kreditzusammenfassung alle gegen einen Anbieter laufen, hat eine Abhängigkeit, so viele Anwendungen sie auch zählt. Die deutsche Aufsicht dazu steht unter DORA in Deutschland, der Cloud-Hintergrund unter Cloud Computing im Banking.
Was der EU AI Act in der Akte erwartet
Kreditwürdigkeitsprüfung natürlicher Personen ist nach dem EU AI Act eine Hochrisiko-Anwendung, die Preisbildung in der Lebens- und Krankenversicherung ebenfalls. Für solche Systeme muss die Dokumentation vor dem Einsatz vorliegen: was das System tut, welche Daten es trainiert oder konfiguriert haben, welche Grenzen bekannt sind, wie die menschliche Aufsicht im Prozess funktioniert, und was das System auf dem Testdatensatz bei Genauigkeit und bei Widerstandsfähigkeit gegen gestörte Eingaben erreichte. Betriebsprotokolle sind aufzubewahren.
Die Infrastrukturentscheidung steht direkt in dieser Akte. Ein selbst betriebenes Modell mit festgepinnter Version liefert die Nachweise auf Anfrage; eine geschlossene API, deren Version der Anbieter wechselt, braucht eine vertragliche Zusage zu Versionsaufbewahrung und Protokollzugang, eingeholt vor dem Einsatz und nicht bei der ersten Aufsichtsfrage. Das Regime behandelt Finance Loop unter EU AI Act in der Finanzbranche.
Capex, Opex und die gemischte Antwort der meisten Banken
Die Kostenformen unterscheiden sich stärker als die Summen. Ein Eigenbau ist vorgezogenes Kapital: Beschleuniger vor dem ersten Nutzer, Rechenzentrumsfläche, physische Sicherheit und Personal, das die Hardware betreiben kann. Cloud-Mandanten sind Betriebsaufwand, der mit der Nutzung wächst, was einer noch nicht dimensionierten Last entgegenkommt und eine über Jahre gleichmäßig hohe bestraft. Die souveräne Variante legt einen Zuschlag auf die einfache eigene Mandantenfähigkeit, für die Zusagen zur Rechtsordnung.
Heraus kommt in der Praxis ein Portfolio und keine einzige Wahl. Die Entscheidung gehört zur Datenklasse und nicht zum Institut: Lasten mit den sensibelsten Kundendaten gehen in die strengste Umgebung, alles andere dorthin, wo die Bereitstellung schnell ist. Sphere argumentiert von der Kostenseite genauso und warnt davor, überall für Kontrolle zu zahlen, die die Bank nicht überall braucht. Eine Bank mit einer Umgebung für alle KI-Lasten hat entweder bei den leichten zu viel bezahlt oder die schweren falsch platziert.
Die Reihenfolge, die hält, ist Aufsicht zuerst und Kaufmännisches danach. Eine Vorgabe, dass Daten das Gebäude nicht verlassen, entscheidet für das eigene Rechenzentrum. Eine Residenzpflicht entscheidet für eine souveräne Umgebung. Eine Anforderung an Trennung und Prüfbarkeit ohne Residenzpflicht erfüllt meist eigene Mandantenfähigkeit. Erst wenn keine der drei bindet, geht es um Preis und Tempo.
Was ist KI-Infrastruktur?
KI-Infrastruktur ist die Schicht aus Rechenleistung, Speicher, Netz und Software, auf der Modelltraining und Modellinferenz laufen: Beschleuniger und die Hosts darum, breitbandiger Speicher für Daten und Modelldateien, ein Netz, das die Beschleuniger nicht warten lässt, und darüber Orchestrierung, Serving und Monitoring. In einer Bank gehören Identitäts-, Protokoll- und Berechtigungssysteme dazu, die die Nutzung prüfbar machen.
Kann eine Bank ein LLM auf eigenen Servern betreiben?
Ja, und viele tun es für die Lasten, bei denen die Daten nicht hinausdürfen. Ein Open-Weight-Modell der üblichen Größen läuft auf einem Server mit einigen Beschleunigern, also einer normalen Beschaffung und keinem Rechenzentrumsprojekt. Es wächst nicht die Hardware, sondern die Arbeit daneben: Versionsverwaltung der Gewichte, ein Evaluationssatz, der bei jeder Änderung neu läuft, Kapazitätsplanung für gleichzeitige Nutzer, und ein Monitoring, das eine verschlechterte Antwort fängt, bevor jemand darauf handelt.
Was heißt souveräne KI in der Finanzbranche?
Souveräne KI in der Finanzbranche heißt, dass Modelle, Daten und Rechenleistung unter dem Recht einer Rechtsordnung und bei ihm unterworfenen Betreibern bleiben, damit kein fremdes Zugriffsregime an Kundendaten kommt und keine fremde Entscheidung die Fähigkeit entzieht. Für eine europäische Bank sind das drei getrennte Dinge: wo die Daten liegen, wer die Schlüssel hält und wer an die Steuerungsebene kommt. Ein Aufbau kann eines davon erfüllen und bei den anderen zwei durchfallen, darum gehört der Begriff in jedem Vertrag aufgeschlüsselt.
Wie viel GPU-Kapazität braucht eine Bank für ein eigenes Modell?
Für Inferenz auf einem Open-Weight-Modell der üblichen Größen versorgt ein Server mit wenigen Beschleunigern eine Abteilung, und die Dimensionierungsfrage ist Gleichzeitigkeit und nicht Modellgröße: wie viele Nutzer in derselben Sekunde eine Antwort erwarten und wie lang die Antworten sind. Für Nachtraining auf eigenen Dokumenten sind eine Handvoll Beschleuniger über Stunden je Lauf realistisch, und der Lauf wiederholt sich, sobald sich die Dokumentenbasis ändert. Ein Basismodell von null zu trainieren ist eine andere Größenordnung und nichts, was eine Bank planen sollte. Vergessen wird die zweite Umgebung: Eine Produktion braucht eine Testumgebung mit derselben Modellversion, sonst gibt es keinen Ort, eine Änderung zu prüfen.
Was unterscheidet Private Cloud und souveräne Cloud?
Eine Private Cloud gibt eigene Mandantenfähigkeit und logische Trennung auf der Plattform eines Anbieters, die Last der Bank teilt also keine Rechenleistung mit anderen Kunden. Eine souveräne Cloud fügt Zusagen zur Rechtsordnung hinzu: dass Daten, Schlüssel und operative Kontrolle in einem benannten Rechtsraum bleiben, bei einem diesem Recht unterworfenen Betreiber. Der Unterschied zeigt sich, wenn eine ausländische Behörde beim Anbieter Daten verlangt. Logische Trennung beantwortet dieses Verlangen nicht, eine Zusage zur Rechtsordnung ist dafür geschrieben.
KI-Infrastruktur in Banken und Finance Loop
Finance Loop ist in Frankfurt der Treffpunkt für den Bereich digitale Infrastruktur & Souveränität, in dem die Leute sitzen, die Cloud-Verträge zeichnen, die Architekten, die Beschleuniger dimensionieren, und die Risikomanager, die für die Abhängigkeit haften. Mitglieder erfahren, was eine Infrastrukturentscheidung bei anderen gekostet hat, bevor sie die eigene treffen. Finance Loop hält die Diskussion am Betriebsalltag und nicht an Anbieter-Roadmaps.
Finance Loop ist ein Experten-Netzwerk mit dem Ziel, die Einführung neuer Technologien in der Finanzbranche voranzubringen, etwa KI, Tokenisierung, Stablecoins und DeFi. Finance Loop hilft seinen Mitgliedern, Kompetenzen und persönliche Netzwerke in diesen Feldern aufzubauen: Investment & digitale Vermögenswerte, Payments & digitales Geld, digitale Infrastruktur & Souveränität sowie Risiko & Compliance.