
Infrastructure IA bancaire
L’infrastructure IA bancaire comprend équipements de calcul, logiciels et accès aux données nécessaires à l’exploitation et, au besoin, à l’entraînement des modèles. Un modèle entraîné traite de nouvelles entrées pendant l’exploitation, étape appelée inférence. Les banques choisissent leurs systèmes, le cloud ou des services hébergés, avec des coûts et contrôles des données différents.
Les banques ont besoin d’un environnement technique fiable avant de traiter quotidiennement des informations métier par IA. Permissions, suivi et capacité déterminent les utilisateurs autorisés et la vérifiabilité des résultats. Les applications bancaires en Allemagne doivent aussi respecter les règles de l’IA en finance en Europe.
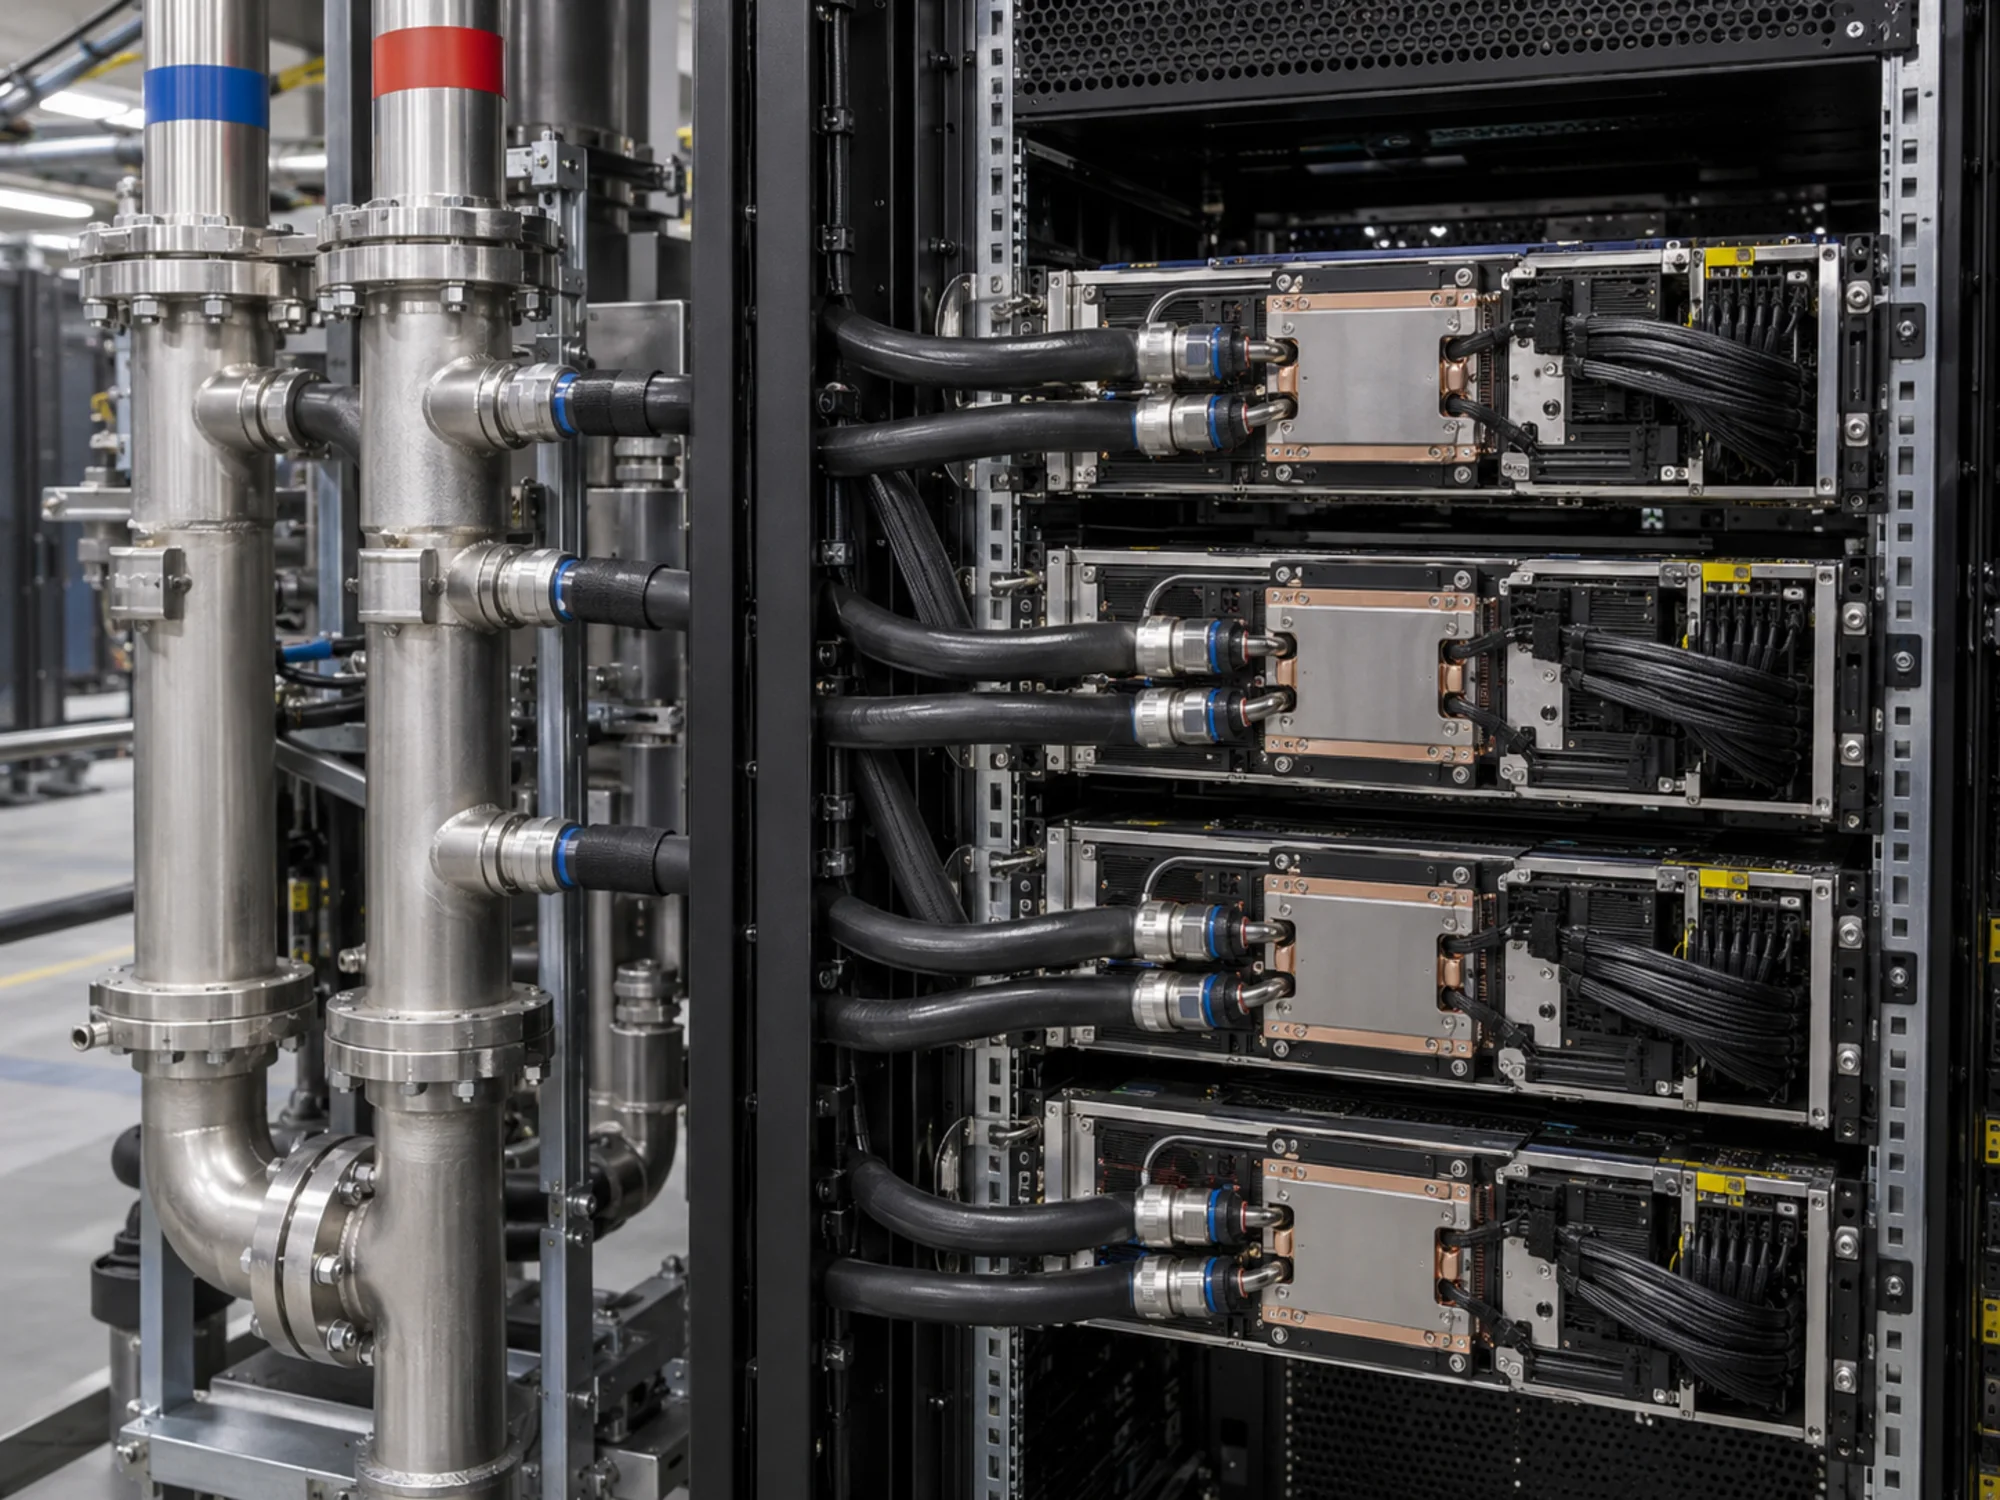
Charges d’entraînement et d’inférence
Presque aucune banque n’a besoin d’entraîner un modèle de fondation, et celles qui le croient recherchent généralement autre chose. Partir de zéro exige des milliers d’accélérateurs pendant des semaines, une chaîne de données inédite en interne et un résultat inférieur aux versions ouvertes. Affiner un modèle existant sur les documents bancaires est d’une autre échelle: dizaines d’accélérateurs pendant des heures, processus reproductible et modèle contrôlé par la banque.
L’inférence constitue la charge réellement récurrente, chaque question d’un analyste crédit sur des documents ou résumé de dossier de service, avec la latence fixée par le métier, pas celle annoncée par le fournisseur. La notation antifraude en temps réel sépare les deux: une décision dans l’autorisation d’un paiement ne peut attendre un aller-retour vers une API externe; cette exigence impose une infrastructure sous contrôle bancaire. La recherche dans ses données améliore généralement davantage les réponses qu’un nouvel entraînement, car le modèle n’était pas la partie privée de connaissance bancaire.
Centre propre, cloud privé, souverain ou hyperscaler
L’infrastructure IA peut fonctionner dans quatre environnements aux problèmes distincts. Le centre de données propre offre le contrôle le plus fort: modèle, inférence et chaîne de données dans des locaux possédés ou loués, sans sortie des données clients. Le coût comprend accélérateurs, alimentation et refroidissement de baies plus consommatrices que les serveurs remplacés, et un cycle de renouvellement matériel désormais bancaire.
Un cloud souverain confie la charge à un opérateur soumis à une juridiction: engagements contractuels, parfois légaux, maintenant données, clés de chiffrement et contrôle opérationnel dans un espace juridique nommé, sous un opérateur soumis à ce droit. Le cloud souverain pour les banques décrit ce sujet. Entre les deux se trouve le cloud privé ou privé virtuel: environnement dédié chez un grand fournisseur, isolation logique forte et mise à disposition en semaines plutôt qu’en trimestres. La comparaison des trois modèles par Sphere oppose six à douze mois ou plus pour construire aux semaines pour un environnement dédié, et relève un surcoût de conformité du souverain face au privé. Un hyperscaler offre immédiatement capacité et choix de modèles, laissant à la banque les questions de détention des clés et d’accès au plan de contrôle par du personnel hors UE.
La réponse européenne à ces questions est encore en construction. Lloyds Banking Group et NatWest Group ont rejoint une coalition autour d’un modèle de pointe souverain britannique pour l’exploiter dans leur infrastructure plutôt qu’envoyer les données clients à une API étrangère. La même question anime l’IA souveraine en Allemagne, en lien avec Gaia-X et EU Cloud Code of Conduct.
Poids ouverts ou API fermée et effet sur la piste d’audit
Un modèle à poids ouverts est un fichier détenable par la banque. Trois possibilités le distinguent d’une API fermée: figer la version aussi longtemps qu’un superviseur peut interroger une décision, fonctionner sans connexion réseau sortante et prouver des poids inchangés entre décision et examen. Un modèle fermé derrière une API peut être actualisé par le fournisseur; une décision de la version du trimestre précédent n’est plus reproductible après son retrait.
Les modèles fermés offrent des capacités souvent supérieures aux versions ouvertes et un fournisseur assumant l’exploitation. Les établissements réglementés combinent souvent modèle fermé pour rédaction et recherche sans décision, modèle ouvert auto-hébergé lorsqu’une décision en dépend. La question décisive porte sur les décisions à reconstituer et la durée de conservation nécessaire. Finance Loop traite des modèles dans les grands modèles de langage en finance et l’IA générative en finance.
Résidence des instructions et des résultats
Une instruction contenant un nom de client transfère des données personnelles, à chaque fois, pas seulement au lancement du projet. Le RGPD s’applique à l’instruction, aux journaux du fournisseur, au résultat et à l’index de recherche construit sur les documents clients. Les questions sont concrètes: emplacement physique du service d’inférence, durée et objectif de conservation, usage pour améliorer le modèle, et personnel pouvant lire l’instruction lors d’une assistance.
L’index de recherche est la partie souvent oubliée, une base vectorielle issue de correspondance client contient les mêmes données personnelles, subit les mêmes obligations d’effacement et doit être reconstruite après suppression d’un dossier. Effacer le document source en gardant son vecteur ne constitue pas un effacement.
DORA appliqué au fournisseur de modèles
Un fournisseur de modèles est un prestataire de services TIC tiers, traité comme tel par DORA. Le contrat comporte donc les clauses obligatoires d’accès, audit et sortie, le fournisseur figure au registre d’informations, et l’entreprise doit expliquer le devenir de la fonction s’il arrête son service. Pour un modèle, la sortie est plus complexe que pour une base, car elle doit nommer un substitut et prévoir la migration des instructions, de la recherche et du jeu d’évaluation.
La concentration est la deuxième question de DORA; une banque confiant antifraude, service client et résumés de crédit à un fournisseur a une seule dépendance, quel que soit le nombre d’applications. La supervision allemande est décrite dans DORA en Allemagne, et le contexte cloud dans le cloud computing bancaire.
Le dossier attendu par le règlement IA de l’UE
La notation de crédit des personnes physiques et la tarification vie et santé sont des usages à haut risque selon le règlement IA de l’UE. Leur documentation doit précéder le déploiement: fonction du système, données d’entraînement ou configuration, limites connues, contrôle humain et résultats de précision et de résistance aux entrées perturbées sur le jeu de test. Les journaux de fonctionnement du système doivent aussi être conservés.
Le choix d’infrastructure apparaît directement dans ce dossier; un modèle auto-hébergé à version figée fournit les éléments sur demande; une API fermée aux versions renouvelées exige des engagements contractuels de conservation des versions et d’accès aux journaux avant déploiement, pas à la première question prudentielle. Finance Loop explique ce régime dans le règlement IA de l’UE en finance.
Investissement, exploitation et choix hybride des banques
La structure des coûts diffère davantage que leur total: une construction propre concentre l’investissement initial en accélérateurs avant tout utilisateur, capacité de centre, sécurité physique et personnel compétent. Le cloud est une dépense d’exploitation proportionnelle à l’usage, adaptée aux charges inconnues mais coûteuse à volume élevé constant durant des années. La variante souveraine ajoute une prime juridictionnelle au coût de l’environnement dédié.
Les banques utilisent donc plusieurs environnements, selon la catégorie de données: les données clients les plus sensibles vont dans l’environnement le plus strict, le reste là où la mise à disposition est rapide. Sphere le souligne aussi par les coûts, avertissant contre un contrôle inutile partout. Une banque choisissant un seul environnement a soit trop payé les charges simples, soit mal placé les complexes.
L’ordre pertinent tranche d’abord le réglementaire, puis le commercial; des données devant rester dans l’immeuble imposent un centre propre, une exigence de résidence un environnement souverain. Isolation et auditabilité sans résidence sont généralement satisfaites par un environnement dédié. Sans ces trois contraintes, prix et vitesse deviennent les critères.
Qu’est-ce que l’infrastructure IA?
L’infrastructure IA réunit calcul, stockage, réseau et logiciels pour entraînement et inférence: accélérateurs et hôtes, stockage à haut débit pour données et modèles, réseau évitant l’attente des accélérateurs, puis orchestration, service et suivi. En banque, elle comprend aussi les systèmes d’identité, de journalisation et d’habilitation rendant l’usage auditable.
Une banque peut-elle héberger un grand modèle de langage?
Oui, beaucoup le font pour les charges dont les données ne peuvent sortir. Un modèle ouvert de taille courante fonctionne sur un serveur avec quelques accélérateurs, achat ordinaire plutôt que projet de centre de données. C’est le travail environnant qui augmente: versions des poids, évaluation répétée après chaque modification, capacité des utilisateurs simultanés et suivi détectant une réponse dégradée avant son utilisation.
Que signifie l’IA souveraine en finance?
L’IA en finance souveraine garde modèles, données et calcul sous une juridiction et ses opérateurs, empêchant un régime d’accès étranger d’atteindre les données clients ou une décision étrangère de supprimer la capacité. Pour une banque européenne, trois points distincts: emplacement des données, détenteur des clés de chiffrement et accès au plan de contrôle. Un déploiement peut satisfaire l’un et manquer les deux autres; chaque contrat doit donc préciser le terme.
Quelle capacité GPU pour le modèle propre d’une banque?
Pour l’inférence d’un modèle ouvert courant, un serveur avec peu d’accélérateurs dessert un service; le dimensionnement dépend de la simultanéité, pas de la taille du modèle: utilisateurs attendant dans la même seconde et longueur des réponses. Affiner sur les documents bancaires nécessite quelques accélérateurs pendant des heures par exécution, répétée à chaque changement documentaire. Entraîner un modèle de fondation de zéro change d’échelle et n’est pas ce qu’une banque devrait prévoir. La capacité oubliée est le second environnement: la production nécessite un test à version identique, sinon aucune modification ne peut être validée.
Quelle différence entre cloud privé et cloud souverain?
Le cloud privé offre environnement dédié et isolation logique dans la plateforme d’un fournisseur, sans partager le calcul bancaire avec d’autres clients. Le cloud souverain ajoute des engagements juridictionnels: données, clés de chiffrement et contrôle opérationnel restent dans un espace juridique nommé, sous un opérateur soumis à ce droit. La différence apparaît lorsqu’une autorité étrangère demande des données; l’isolation logique n’y répond pas, l’engagement juridictionnel est conçu pour cela.
Infrastructure IA bancaire et Finance Loop
Finance Loop réunit à Francfort, dans son axe Infrastructure numérique & souveraineté, signataires des contrats cloud, architectes dimensionnant les accélérateurs et gestionnaires de risque responsables des dépendances. Les membres de Finance Loop entendent ce qu’une décision d’infrastructure a coûté à d’autres avant de décider. Finance Loop centre les échanges sur l’exploitation concrète de l’infrastructure IA.
Finance Loop est un réseau professionnel qui favorise l’usage institutionnel des technologies émergentes en finance, comme l’IA, la tokenisation, les stablecoins et la DeFi. Finance Loop aide ses membres à développer leurs compétences et réseaux personnels dans ces domaines: Investissement & actifs numériques, Paiements & monnaie numérique, Infrastructure numérique & souveraineté et Risque & conformité.