
Exploration web & extraction de connaissances Francfort
L'exploration web est la récupération automatisée de pages dans un périmètre de sources défini. L'extraction de connaissances identifie des faits dans les contenus récupérés et les place dans des champs convenus, comme un nom de produit ou une catégorie de service. Les données obtenues peuvent être vérifiées avec les informations sources.
Un projet utile commence par des sources autorisées et des exemples des données nécessaires à l'entreprise. Les équipes de Francfort et de Rhin-Main peuvent alors évaluer si les faits extraits servent une analyse précise ou un processus interne. Les liens sources et les lacunes explicites facilitent la vérification avant toute utilisation ultérieure.
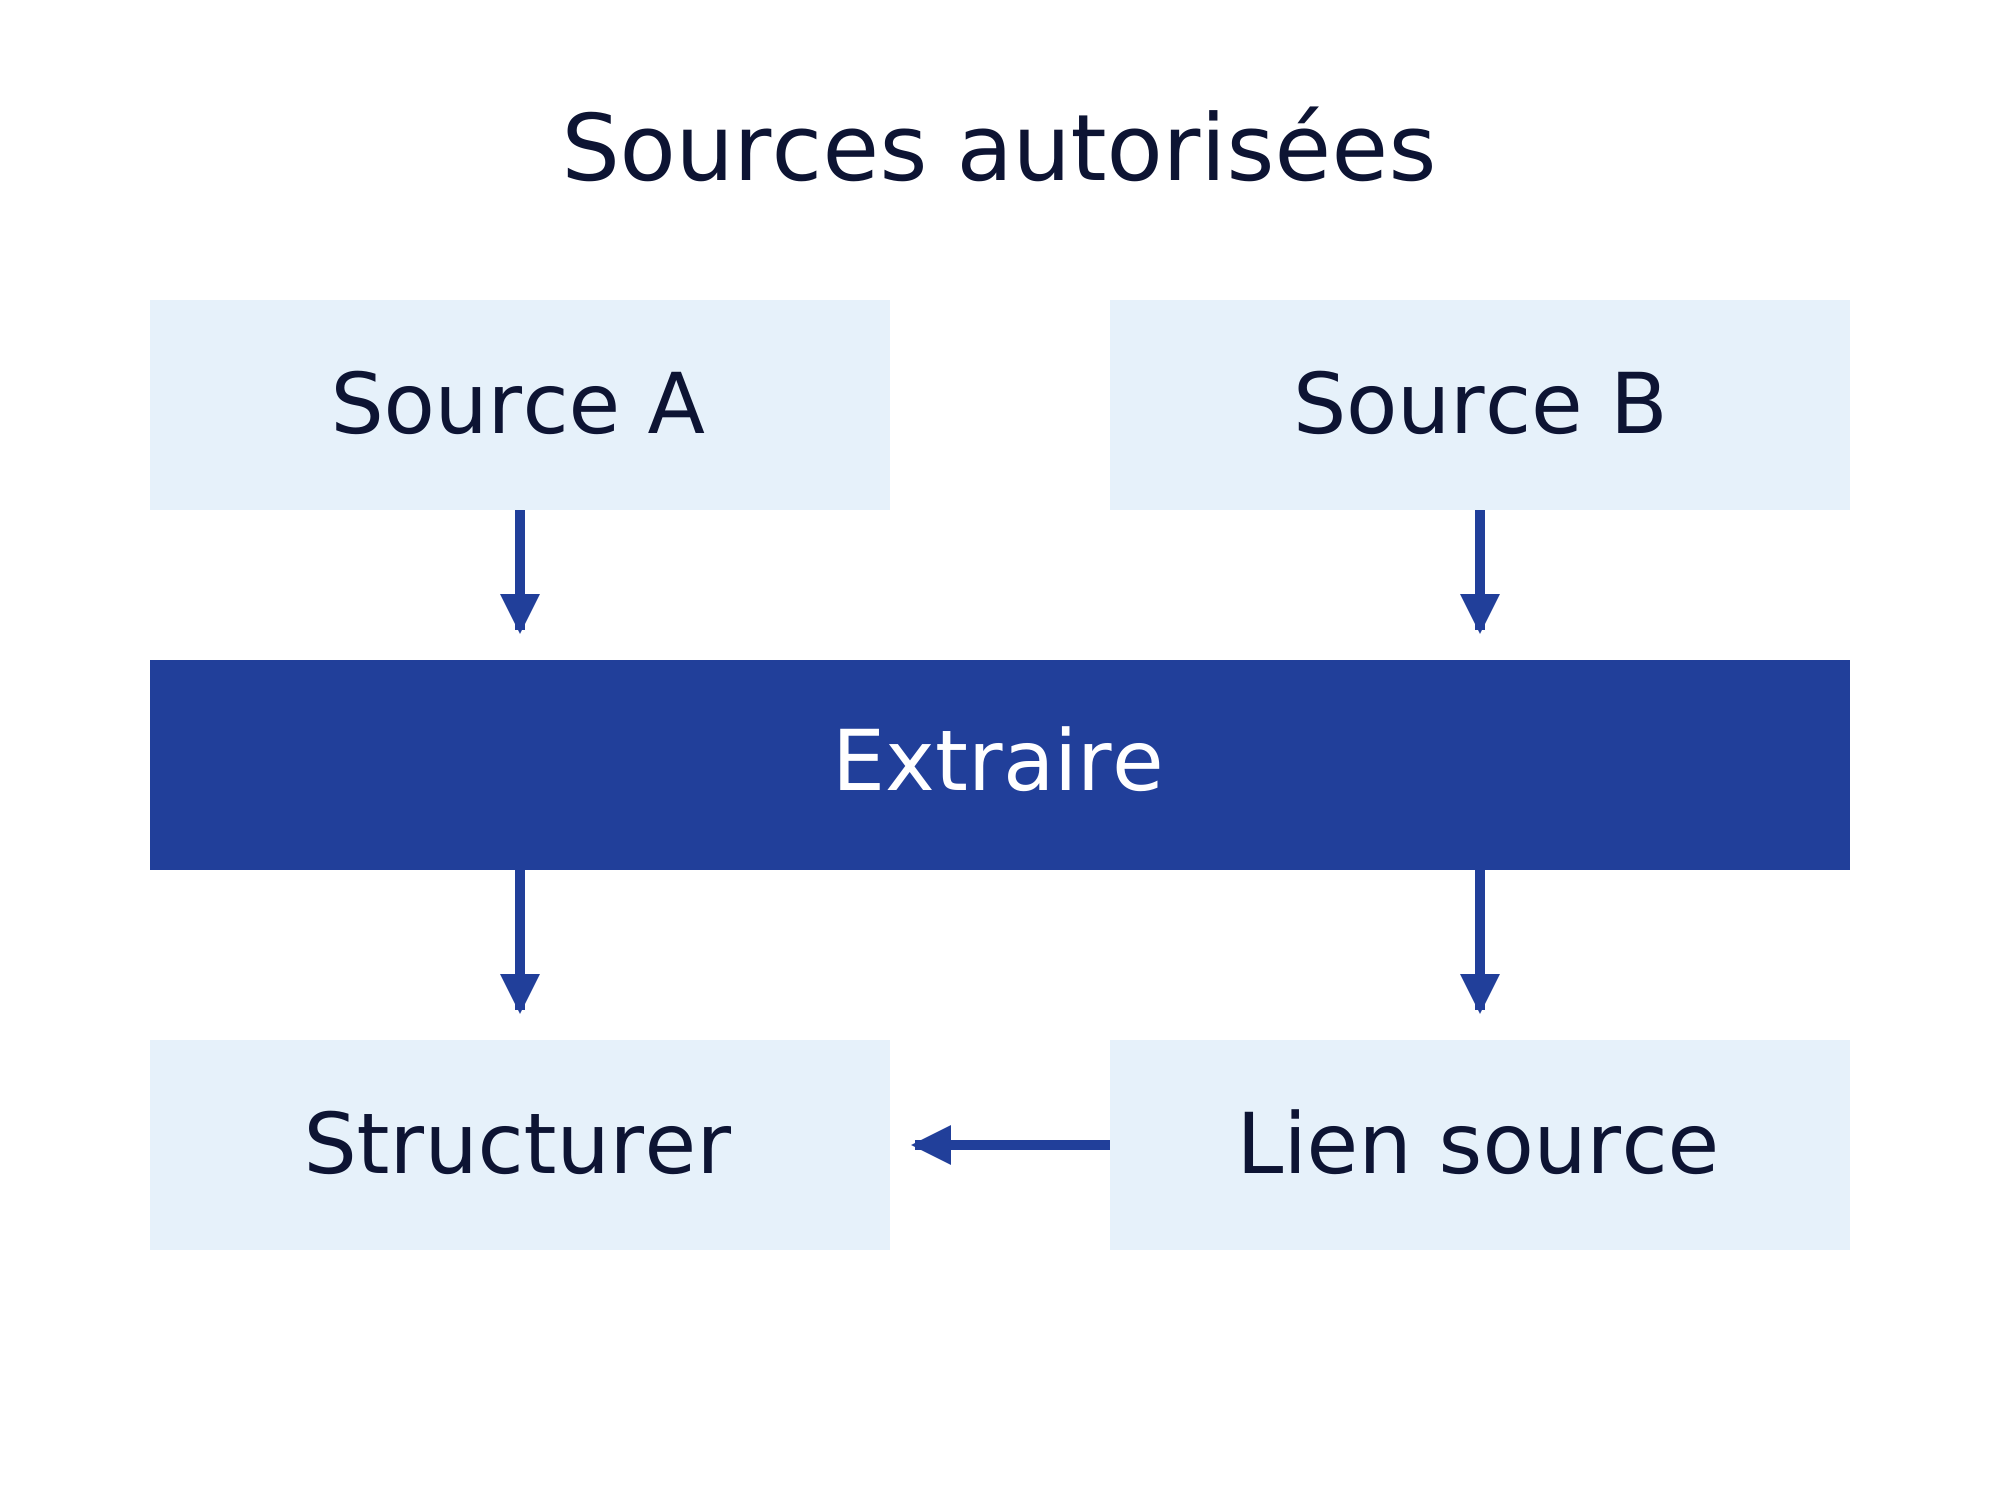
Exploration, extraction et données utilisables
Un robot détermine les pages à récupérer et suit les liens dans les limites convenues. Une étape d'extraction sélectionne le contenu pertinent et attribue des valeurs aux champs cibles. Une page récupérée peut donc être disponible techniquement, tandis qu'un champ requis reste absent ou ambigu.
Définissez la sortie avant de collecter de nombreuses pages issues de sources différentes. Une fiche produit peut nécessiter un nom, une catégorie et l'adresse de la source justificative. Les champs requis devraient suivre la tâche métier prévue, avec des exemples de résultats acceptables et incomplets.
Sources autorisées et récupération maîtrisée
Convenez des domaines autorisés, des types de pages pertinents et des limites de récupération avant toute exploration. Le Robots Exclusion Protocol définit les règles communiquées par les exploitants de sites aux clients automatisés. Ces règles ne constituent pas une autorisation d'accès, donc les permissions et les usages autorisés des données nécessitent leur propre examen.
Pour chaque source, consignez l'objectif prévu et les champs autorisés dans la sortie. Convenez du traitement d'une requête bloquée ou d'une page indisponible dans le processus. Un export existant ou une interface autorisée peut fournir un accès plus direct aux mêmes faits nécessaires.
Conserver la source de chaque fait extrait
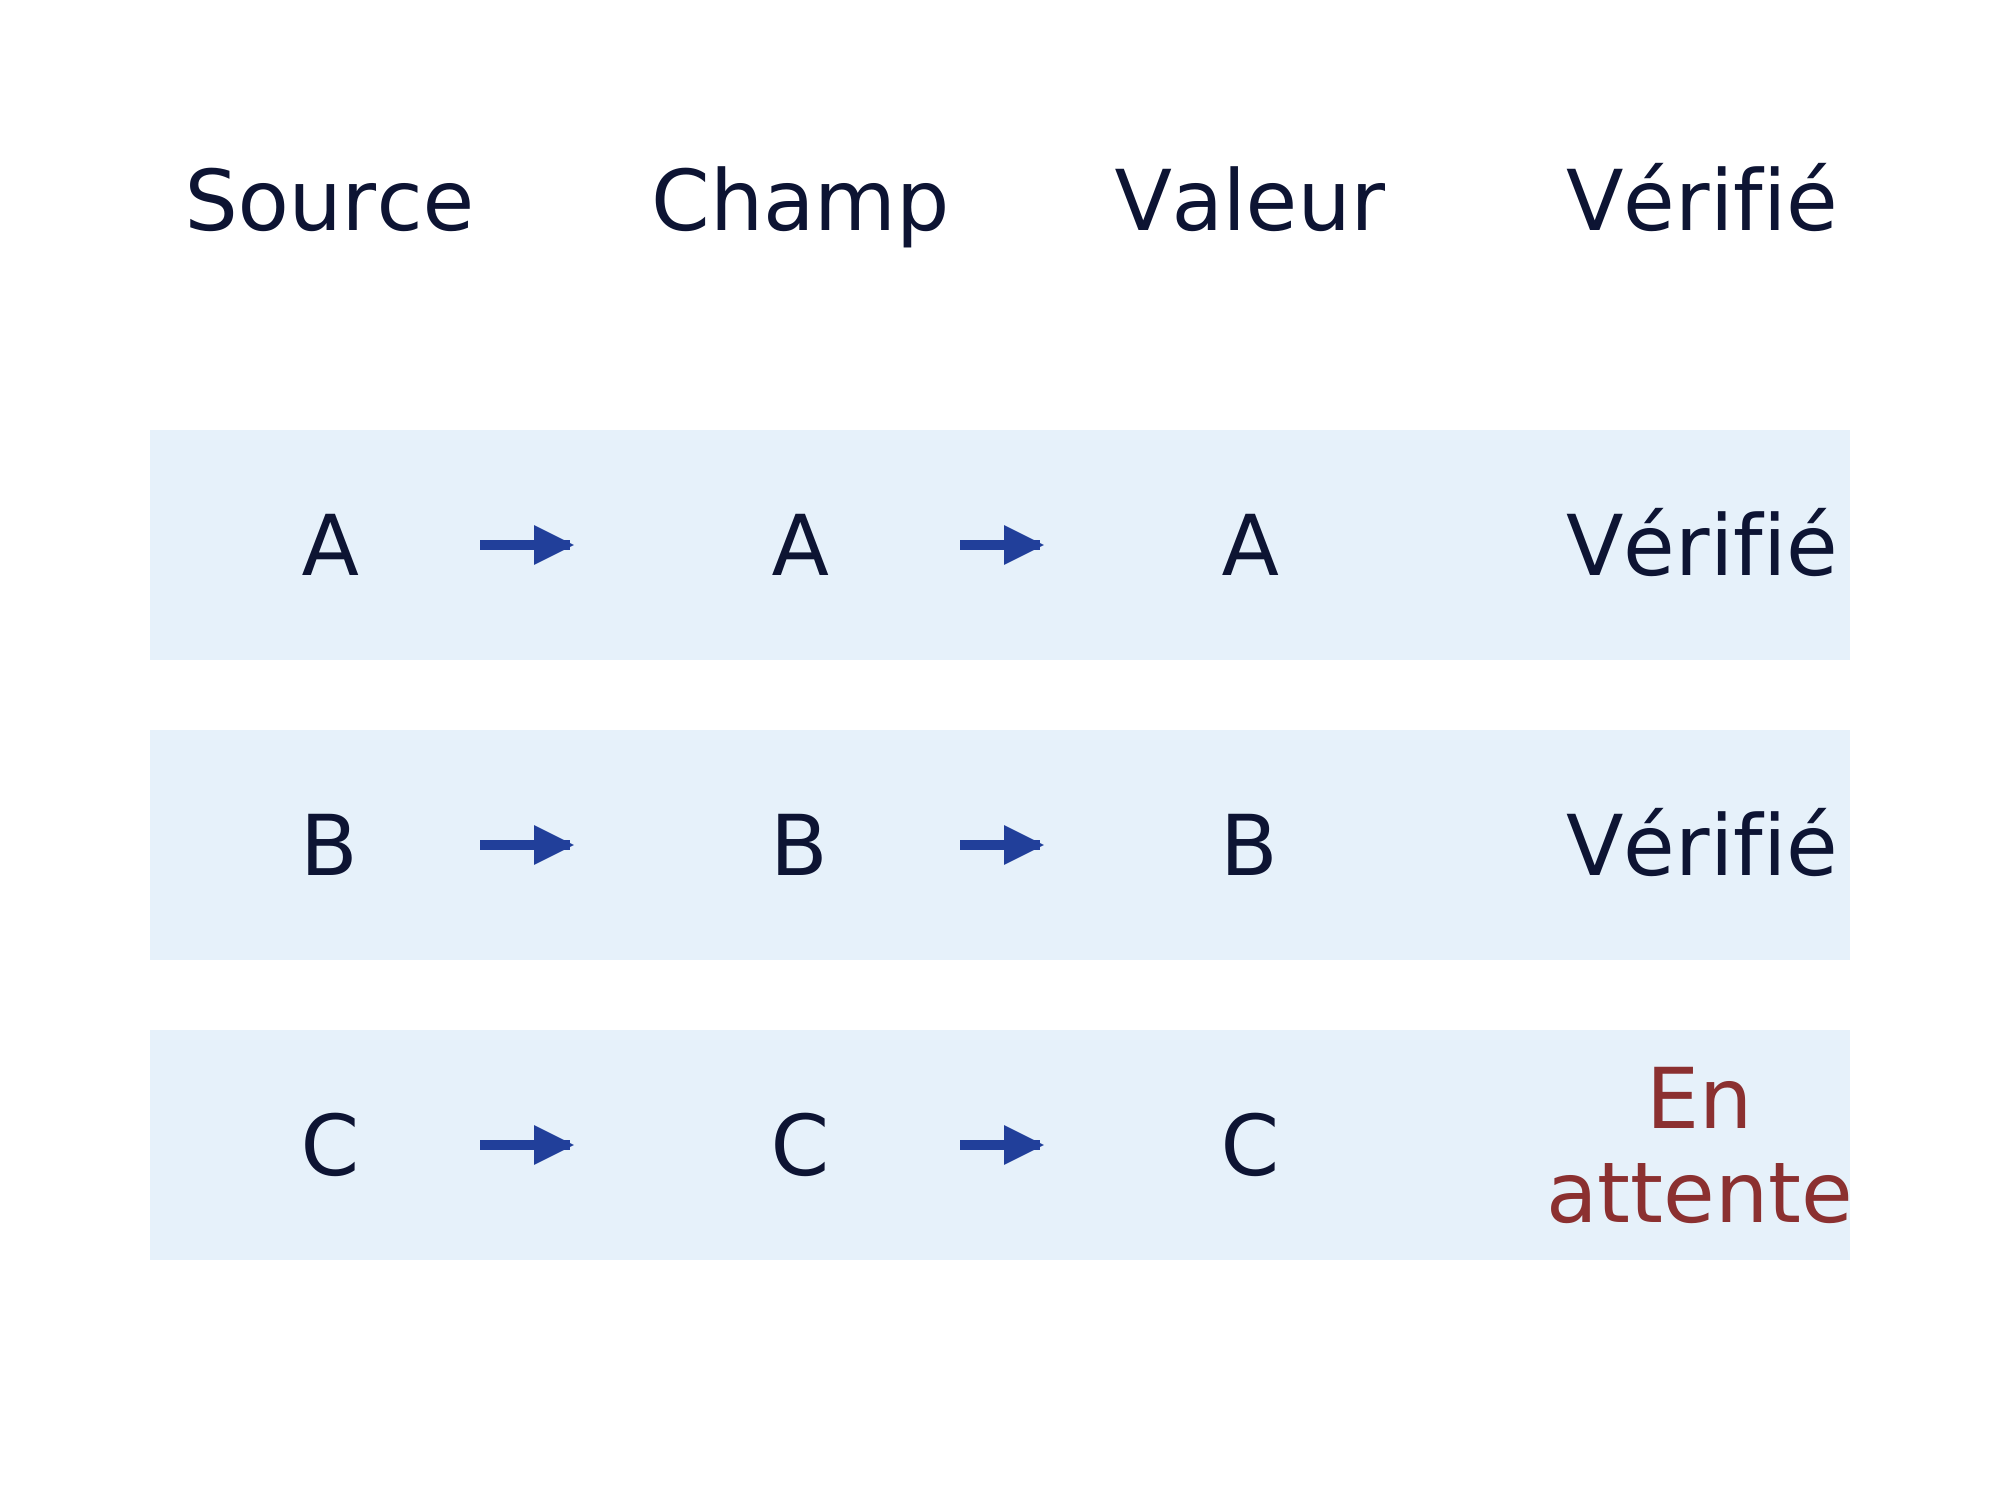
La provenance d'un enregistrement décrit l'origine des données et leur mode de production. Le modèle de provenance du W3C couvre les entités, activités et personnes participant à la production d'informations. Pour un jeu de données métier, une fiche de contrôle utile relie un champ et sa valeur à la source justificative et au contrôle effectué.
La fiche de contrôle relie la source originale au champ choisi et à sa valeur. Un statut indique si une personne a vérifié cette valeur avec la source. Conservez une valeur manquante comme telle lorsque la source ne fournit pas le fait demandé. Si des sources divergent, conservez le conflit et transmettez le champ concerné au réviseur convenu avant toute utilisation en aval.
Comment vérifier la qualité de l'extraction?
Réservez un échantillon de sources qui n'a pas servi à configurer l'extraction. Comparez les données obtenues à une référence vérifiée et examinez séparément les valeurs incorrectes et les valeurs manquantes. Testez les pages dont la structure a changé et les récupérations échouées, ainsi que les exemples simples.
La validation technique peut contrôler les champs requis avant l'entrée des données en base ou dans un export. Le pipeline d'éléments Scrapy permet la validation et le stockage après extraction, avec la collecte et le contrôle comme étapes distinctes. Un réviseur métier doit encore déterminer si une valeur techniquement valide exprime le bon fait.
Que doit prévoir le contrat de livraison?
Précisez le périmètre des sources, le format de sortie et l'échantillon de recette dans le cahier des charges. Demandez si la livraison consiste en un jeu ponctuel ou comprend un processus opérationnel. Convenez des responsables des sources défaillantes et de l'approbation des modifications du modèle de données.
Pour les équipes de Francfort et de Rhin-Main, un examen commun de l'échantillon peut fixer la terminologie avant une collecte élargie. Convenez de la langue de travail et du responsable qui accepte les données obtenues. Séparez la résolution des doublons de l'extraction initiale et définissez les mises à jour continues comme une tâche d'exploitation supplémentaire.
Extraire les informations sur les services dans le Rhin-Main
Un jeu de données sur les services disponibles à Francfort, Wiesbaden ou Darmstadt exige des champs distincts pour l'adresse du prestataire et sa zone déclarée. Une adresse à Francfort ne prouve pas qu'une entreprise accepte des missions dans tout le Rhin-Main. Convenez de l'énoncé source justifiant chaque lieu et conservez cet énoncé avec l'enregistrement extrait. Appliquez les mêmes définitions de champs lorsque la collecte autorisée s'étend à une autre région allemande, pour vérifier la couverture régionale de manière cohérente.
Gateflow parmi les prestataires à Francfort
Gateflow compte parmi les prestataires à Francfort, avec des projets allemands définis pour une intervention à distance ou sur place. Gateflow transforme des sites autorisés et des fichiers contrôlés en données reliées aux preuves sources. Une première mission peut tester l'extraction sur un échantillon de sources défini.
Extraction de connaissances et Finance Loop
Finance Loop rassemble des professionnels des données et de l'IA dans des formats pratiques à Francfort. La série Claude Hacker House permet de discuter de la qualité des sources et de tester des processus d'IA. Finance Loop est un réseau professionnel qui favorise l'usage institutionnel des technologies émergentes dans la finance.