
Indexation blockchain
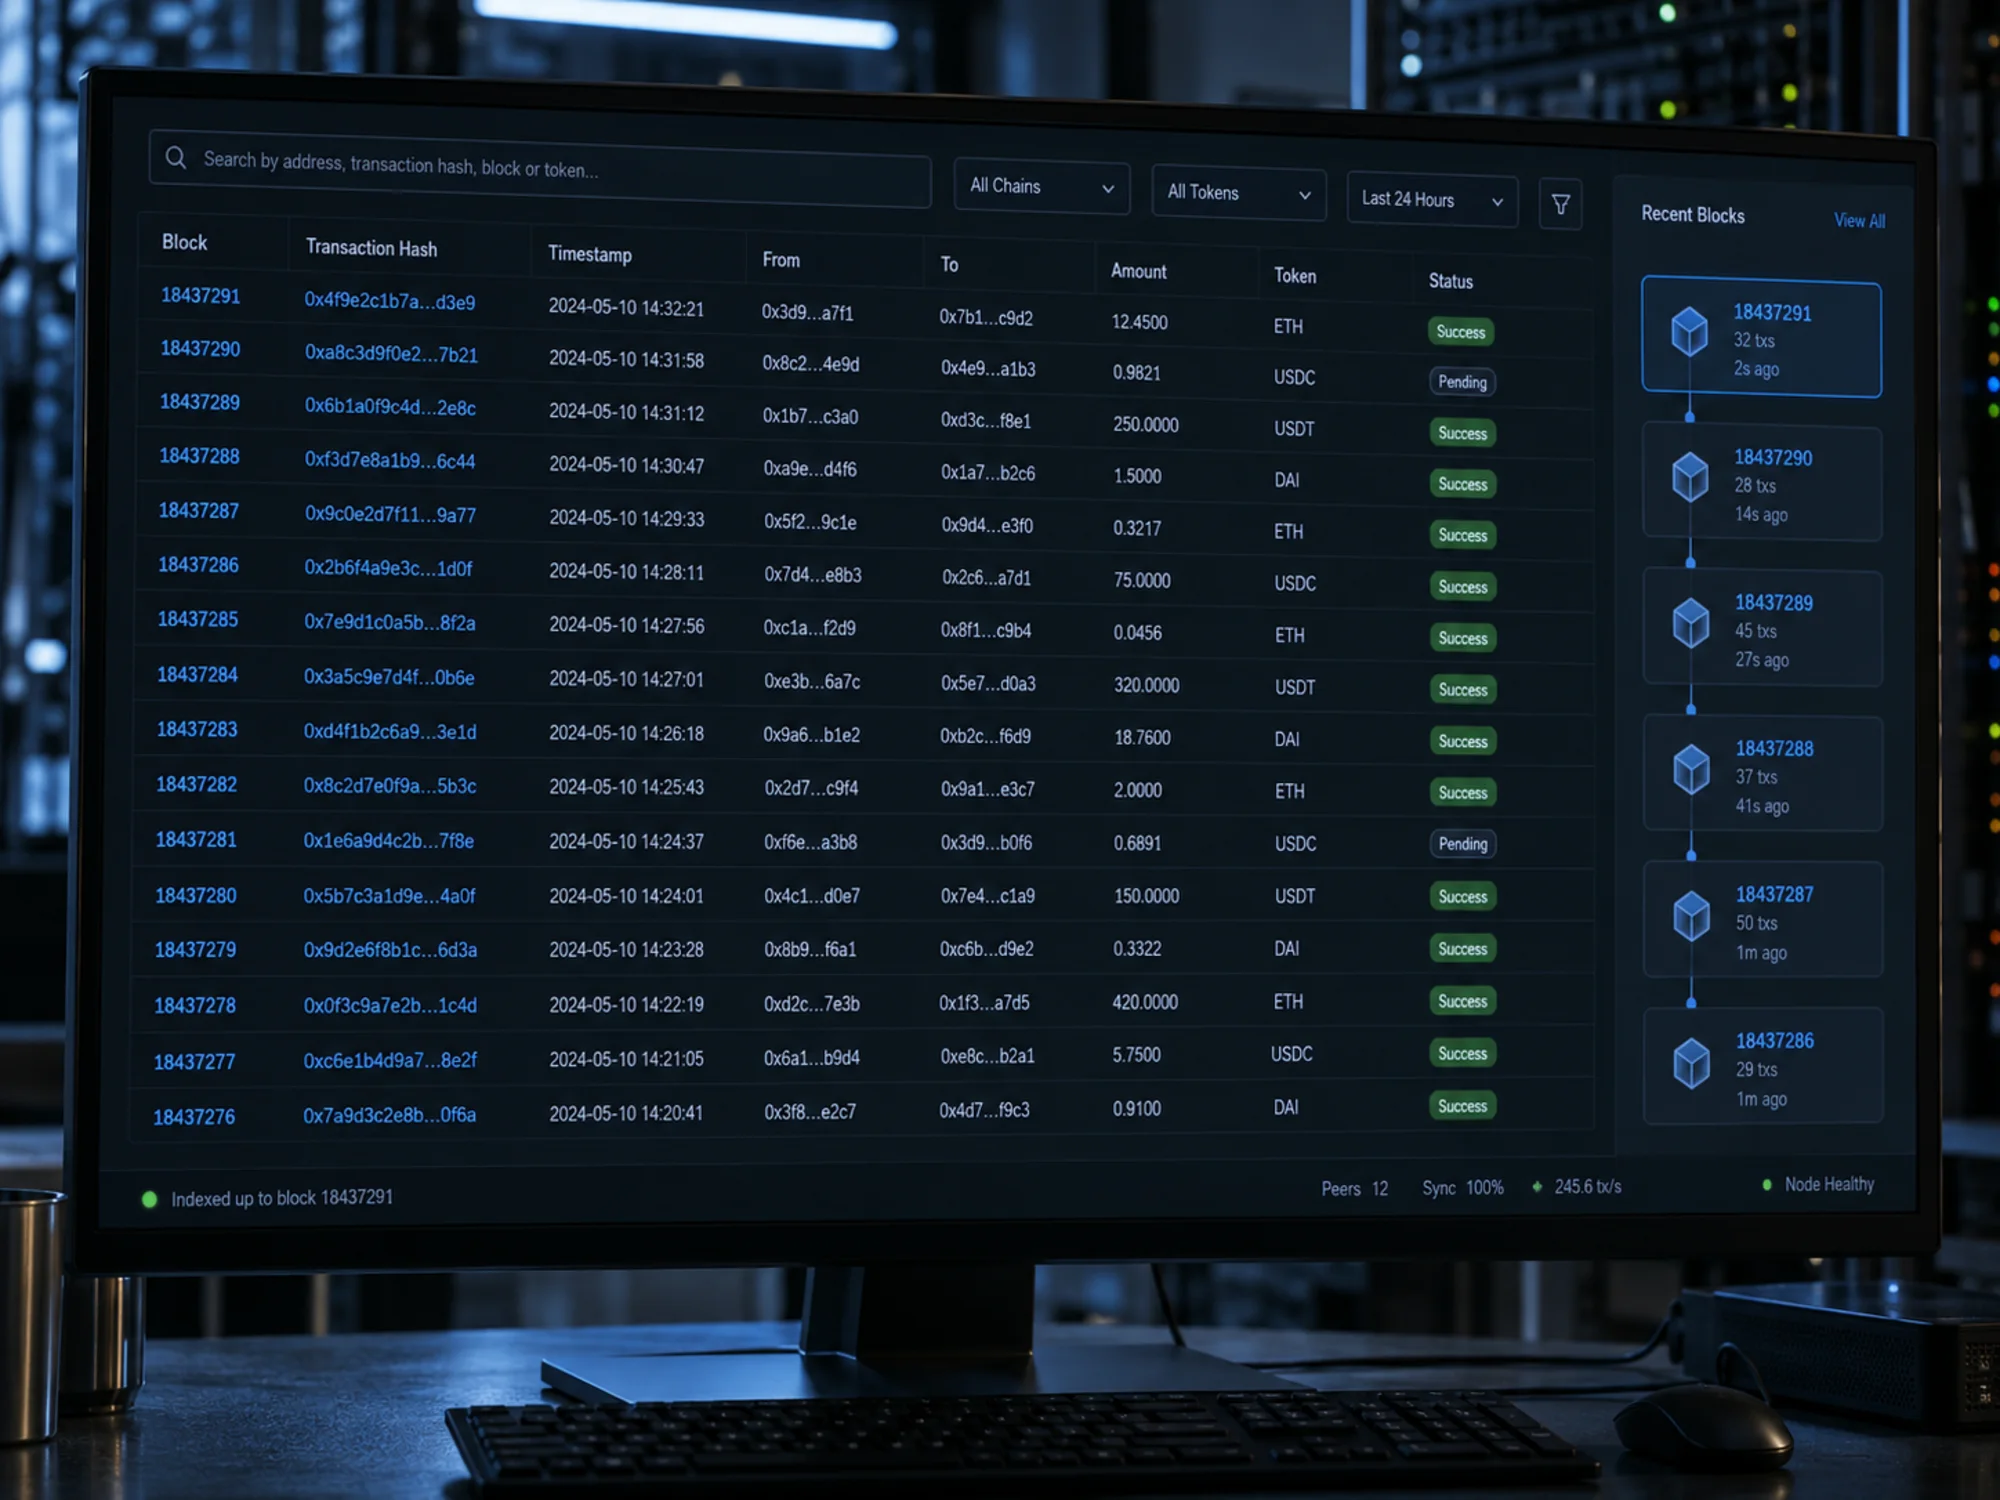
L'indexation des données blockchain organise les transactions, les événements et les autres enregistrements d'une blockchain pour que des applications puissent les rechercher et les analyser. Un index range les données brutes du réseau dans une structure adaptée à des requêtes précises. Les développeurs peuvent alors récupérer les transferts d'un wallet ou l'activité d'un contrat sans construire chaque requête directement à partir de la suite des blocs.
Les applications ont besoin d'indexation, car un registre de transactions ne fournit pas de lui-même une base de données interrogeable pour chaque tâche. Les données indexées servent à afficher des soldes, à rechercher des transactions et à analyser l'activité passée. Un indexeur doit tenir compte des changements de la chaîne sous-jacente, y compris des réorganisations qui remplacent des blocs déjà observés.
Pourquoi un bloc a la mauvaise forme pour une question
Une chaîne stocke des blocs à la suite, chacun contenant des transactions et les logs qu'elles ont émis. Rien dans cette structure ne répond à une question comme « tous les transferts impliquant cette adresse » ou « le solde de ce jeton sur ces cent comptes », car les données sont organisées par date et non par sujet. Répondre à une telle question à partir de la seule chaîne oblige à parcourir des millions de blocs dans l'ordre, et c'est pourquoi les méthodes RPC standard ne le proposent pas.
Un indexeur résout ce problème en inversant l'organisation. L'indexeur lit les blocs une fois, extrait les événements et les traces d'exécution, les décode en enregistrements à champs nommés et les écrit dans une base de données indexée sur les champs que l'on interroge. Ce traitement est un pipeline d'extraction, de transformation et de chargement du type qu'une banque exploite déjà pour d'autres données. La requête prend alors quelques millisecondes, car le travail a été fait à l'avance.
Événements contre traces, et pourquoi il faut les deux
Un log d'événement est ce qu'un contrat a émis volontairement, si bien qu'il est peu coûteux à lire et dépend du fait que l'auteur du contrat l'ait émis. La plupart des transferts de jetons apparaissent comme des événements, et c'est pourquoi un historique de transferts est la chose la plus facile à indexer.
Les traces d'exécution sont l'enregistrement de ce qui s'est réellement passé dans une transaction, y compris les appels internes entre contrats qui n'ont rien émis. Elles sont nécessaires exactement là où les événements manquent ou induisent en erreur: un transfert de monnaie native dans un appel de contrat, un sous-appel échoué dans une transaction par ailleurs réussie, ou un contrat qui ne journalise tout simplement pas une action. Pour une entreprise qui lit l'index d'un prestataire, la conséquence pratique est de demander sur lequel des deux il repose, car un index construit sur les seuls événements a des angles morts qui n'apparaissent que lorsqu'un solde ne se rapproche pas.
Les subgraphs et les services d'indexation derrière eux
The Graph est le protocole d'indexation décentralisé le plus utilisé, et son unité de travail est le subgraph: une spécification qui nomme les contrats à surveiller, les événements à écouter et la manière de projeter ces données d'événements dans un schéma interrogeable en GraphQL. Des opérateurs indépendants appelés indexeurs effectuent le traitement et servent les requêtes.
Un prestataire d'indexation géré exploite le pipeline et livre une API. Cette forme supprime l'exploitation et ajoute un fournisseur. Un service push ou de streaming inverse le sens et livre des données de chaîne filtrées dans la destination propre de l'entreprise au moment où elles se produisent. Cette forme convient à une entreprise qui veut ces données dans son propre entrepôt, à côté de tout ce sur quoi elle fonde ses rapports. Datashare de Dune suit ce modèle et place des jeux de données onchain de Dune dans l'environnement Snowflake, BigQuery, Databricks ou Amazon S3 de l'entreprise. Chacune des trois est une dépendance différente, et la question DORA de la page sur les fournisseurs RPC s'applique à toutes.
Reorgs: quand la chaîne change d'avis
Une réorganisation de chaîne se produit quand la chaîne canonique change parce que des blocs concurrents ont été produits à la même hauteur et que le réseau retient un autre fork que celui que l'indexeur a déjà traité. Un indexeur qui ne traite que les blocs au-delà du seuil de finalité n'a jamais à gérer ce cas, et un indexeur qui suit la tête de chaîne y est toujours confronté. Tout ce que l'indexeur a écrit à partir des blocs orphelins est alors faux: des transactions qu'il a enregistrées comme effectuées n'ont pas eu lieu sur la chaîne que tous les autres suivent désormais.
Un indexeur correct détecte donc la reorg, annule les enregistrements concernés et retraite à partir du point de fork, et un indexeur qui ne le fait pas affiche des transactions fantômes qui ne se règlent jamais. Un chiffre lu avant la finalité peut être révisé, si bien qu'un processus de reporting ou de valorisation doit indiquer quelle profondeur de confirmation il traite comme définitive et doit pouvoir corriger quand une reorg franchit cette limite. Un index dont le prestataire ne sait pas décrire sa gestion des reorgs ne devrait pas être la source d'un chiffre publié. Les Dune Market Data Feeds, qui diffusent les trades de plateformes d'échange décentralisées, décrivent ouvertement leur gestion: quand une reorg modifie un bloc, le flux renvoie ce bloc, et chaque message de trade renvoie à la transaction qui l'a réglé.
Décoder un contrat: ABI, proxys et mises à jour
Les données de chaîne arrivent en hexadécimal. Les transformer en champ nommé exige l'ABI du contrat, la description d'interface qui indique quel événement a quels paramètres dans quel ordre, et sans la bonne ABI un événement est un bloc de données indécodable. Un index dépend donc d'une information qui vit en dehors de la chaîne.
Les contrats proxy compliquent cela d'une manière qui piège les processus de reporting. Un proxy détient le stockage et transmet les appels à un contrat d'implémentation remplaçable, si bien que l'adresse reste la même tandis que la logique et les signatures d'événements changent en dessous. Un index qui décodait avec l'ancienne implémentation continue après une mise à jour à produire des enregistrements plausibles selon le mauvais schéma, et rien dans les données n'annonce le changement. La question à poser à un prestataire est de savoir comment il détecte un changement d'implémentation, et la question pour le propre pipeline d'une entreprise est la même.
Un chiffre indexé n'est pas un chiffre audité
Un nombre tiré d'un index est le résultat d'un pipeline qui comporte des choix: quelles chaînes ont été incluses, quelle profondeur de confirmation a compté comme définitive, quelles adresses ont été attribuées à quelle entité, quelle version d'ABI a servi au décodage, et ce que sont devenus les enregistrements d'une reorg. Deux prestataires peuvent produire deux totaux différents pour le même portefeuille sans qu'aucun ne se trompe sur la chaîne.
Pour la valeur liquidative d'un fonds ou une position publiée par une banque, le chiffre a besoin d'une dérivation documentée et d'un rapprochement avec une seconde source, qui pour les actifs conservés est la comptabilité du dépositaire lui-même. La discipline utile est celle déjà appliquée aux données de marché: nommer la source, nommer l'heure, nommer la méthode, et conserver les données d'entrée pour pouvoir reproduire le chiffre plus tard. La page sur l'analyse onchain en finance traite de la couche d'attribution au-dessus, où l'erreur est plus grande.
Une firme doit-elle créer ou acheter un index?
Acheter pour l'étendue, construire pour les chiffres dont l'entreprise répond. Un indexeur sur mesure donne un contrôle total sur le décodage, la gestion des reorgs et le schéma, et il coûte une équipe pour le construire et le faire tourner: ingestion des blocs, décodage, conception du schéma, reprise après reorg, supervision et retraitement de l'historique à chaque changement de schéma. Un prestataire supprime tout cela et rend les chiffres publiés de l'entreprise dépendants d'une méthode qu'elle ne contrôle pas.
Le partage auquel aboutissent la plupart des entreprises est un prestataire pour l'exploration et une large couverture, plus un pipeline interne étroit pour la poignée de contrats et d'adresses qui alimentent un rapport. Ce pipeline étroit est assez petit pour être validé et audité, et c'est la propriété qui compte.
Combien de temps faut-il pour indexer une chaîne depuis le début?
Indexer une chaîne très active depuis le début prend des jours à des semaines, surtout pour traiter les données historiques. Lire chaque bloc historique, le décoder et l'écrire dans une base de données est limité par le débit de lecture du nœud d'archive et par le débit d'écriture du pipeline, et une chaîne avec des années d'historique et un fort débit représente des téraoctets à traiter. Le piège opérationnel est que tout changement de schéma ou toute correction d'ABI exige de retraiter à nouveau la plage concernée, si bien qu'une entreprise prévoit la réindexation comme un événement normal et non comme un incident.
Données onchain et Finance Loop
Finance Loop réunit les ingénieurs de données qui construisent ces pipelines et les comptables de fonds et équipes de reporting qui doivent défendre les chiffres qui en sortent, dans ses domaines Investissement & actifs numériques et Infrastructure numérique & souveraineté. Finance Loop organise ces sessions à Francfort, près des fonds et des banques qui publient des positions onchain.
Finance Loop est un réseau professionnel qui favorise l'usage institutionnel des technologies émergentes en finance, comme l'IA, la tokenisation, les stablecoins et la DeFi. Finance Loop aide ses membres à développer des compétences et des réseaux personnels dans ces domaines: Investissement & actifs numériques, Paiements & monnaie numérique, Infrastructure numérique & souveraineté et Risque & conformité.